지수 2.0이 진짜 최적일까: 1.83이 어디서 왔는지, 그리고 오버피팅
지난 글의 마지막에 이런 의문을 남겼어요.
2.0이 진짜 최적의 지수일까? 데이터에서 직접 찾아볼 수 있을까?
빌 제임스는 RS² / (RS² + RA²) 라는 공식을 썼고, 그게 5시즌 데이터에 잘 들어맞는다는 걸 지난 글에서 봤어요. 그런데 왜 하필 제곱일까요? 이 지수는 경험적으로 잘 맞아서 쓰인 값이에요. 그리고 야구 분석에서는 1.83 을 쓰는 곳도 있어요. 어느 쪽이 맞을까요?
이번 글의 한 줄 요약은 이거예요.
2.0은 살짝 큰 편이고, 1.83은 합리적이고, 우리 5시즌으로는 1.71이 최적이에요. 그런데 그 차이는 시즌당 0.1~0.4승 정도라 실용적으로는 거의 의미가 없어요.
지수는 우리가 고를 수 있는 숫자예요
먼저 개념을 하나 정리할게요. 피타고라스 기댓값 공식을 일반화하면 이렇게 쓸 수 있어요.
빌 제임스는 k = 2 로 두었지만, 이 k 는 정해진 값이 아니에요. 우리가 고를 수 있어요. 데이터 분석에서 이렇게 모델 안에서 직접 정해주는 숫자를 하이퍼파라미터(hyperparameter) 라고 불러요. 공식의 모양은 정해 두고, 그 안의 숫자 하나만 튜닝하는 자리예요.
기계학습에서는 학습률, 규제 강도, 트리 깊이 같은 이름으로 많이 나오는데, 본질은 같아요. 누가 정해주지 않은 자유도라서, 데이터를 보고 결정해야 하는 자리예요.
그래서 다음 질문은 이거예요. k 를 1.5부터 2.5까지 0.01 간격으로 바꿔 가면서, 어느 값이 실제 승률을 가장 잘 맞추는지 직접 확인해 볼게요.
무엇을 "잘 맞춘다"고 할까
지난 글에서 이미 기준을 골라 뒀어요. MAE — 평균 절대 오차 (Mean Absolute Error) 예요.
각 팀의 실제 승률과 피타고라스 예측 승률 차이의 절댓값을 평균낸 값이에요. 162경기 시즌으로 환산하면 "예측이 평균적으로 몇 승만큼 빗나가는지"가 돼요.
지난 글에서 r 대신 MAE를 본 이유와 같아요. r은 0.95에서 0.9511로 가는 식이라 좁은 폭 안에서만 움직이지만, MAE는 "시즌당 3.5승 빗나가던 게 3.0승으로 줄었나?" 같은 질문에 바로 답해 줘요.
이번처럼 여러 모델 중에 어느 게 더 잘 맞나를 비교할 때는 MAE 같은 오차 지표가 r보다 깔끔해요.
곡선 그려 보기
k = 1.50부터 2.50까지 0.01 간격으로 101개 값을 모두 시험했어요. 각 k 마다 5시즌 150팀 전체에서 MAE를 계산하고, k 를 X축에, MAE를 Y축에 두면 다음 곡선이 나와요.
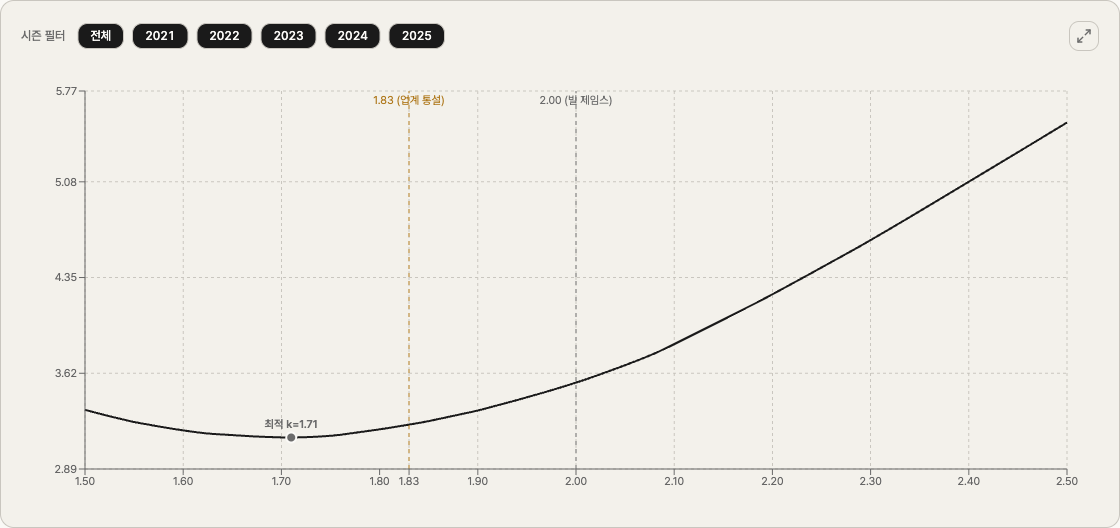
곡선 모양이 분명해요. 왼쪽에서 내려오다가 어느 지점에서 바닥을 찍고, 다시 오른쪽으로 올라가요. 아래로 볼록한 U자예요.
이 U자의 가장 낮은 점이 우리 데이터가 말하는 최적 지수예요. 그 위치는 k = 1.71이에요.
이 k 에서 MAE는 0.01932, 즉 시즌당 약 3.13승 만큼 빗나가요. 빌 제임스의 2.00으로 계산하면 3.55승, 업계에서 자주 쓰는 1.83으로 계산하면 3.23승이었어요. 비교하면 이래요.
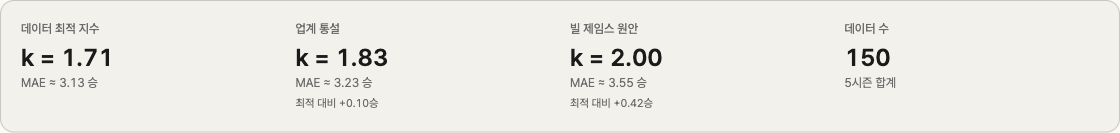
| 지수 | MAE (승) | 최적 대비 |
|---|---|---|
| 데이터 최적 1.71 | 3.13 | — |
| 업계 통설 1.83 | 3.23 | +0.10승 |
| 빌 제임스 2.00 | 3.55 | +0.42승 |
수치만 놓고 보면 "1.71이 최적이고 2.00은 0.42승 더 빗나간다"고 말할 수 있어요. 그런데 이건 한 팀의 시즌당 평균 오차가 0.42승 더 벌어진다는 뜻이에요. 162경기에서 0.4승 차이는 거의 잡음 수준이에요.
1.83과 1.71의 0.10승 차이는 더 작아요. 사실상 같은 값으로 봐도 돼요.
1.83은 어디서 왔을까
1.83은 단일 지수로는 가장 정확한 값으로 알려져 있고, Baseball-Reference가 기대 승률을 계산할 때 쓰는 값이에요. 이번 글과 같은 종류의 비교를, 우리보다 훨씬 긴 기간의 데이터로 한 결과로 자리 잡은 숫자예요.
그래서 우리 5시즌에서 나온 1.71도 새로운 발견은 아니에요. 데이터 표본을 바꿀 때마다 최적값은 조금씩 흔들려요. 1.83은 긴 기간의 데이터에서, 1.71은 5시즌에서 나왔을 뿐이에요.
여기서 다음 의문이 생겨요.
그러면 시즌 하나만 뗐을 때의 최적은 어떻게 흔들릴까?
시즌 하나로만 보면 — 1.57부터 1.76까지
5시즌을 묶어서 본 게 1.71이라면, 시즌 하나(30팀)만 떼서 같은 스윕을 다시 돌리면 어떻게 될까요?
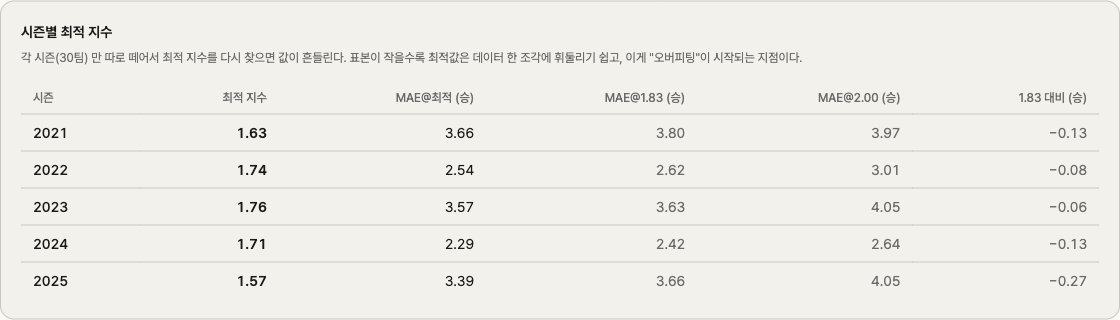
| 시즌 | 최적 k |
|---|---|
| 2021 | 1.63 |
| 2022 | 1.74 |
| 2023 | 1.76 |
| 2024 | 1.71 |
| 2025 | 1.57 |
1.57부터 1.76까지 흔들려요. 폭이 0.19예요. 다섯 값의 평균은 1.68 근처이고, 5시즌을 합쳐서 본 1.71과 가까워요.
왜 시즌마다 다를까요? 시즌 한 번에 30팀이에요. 30개 데이터 점은 통계적으로 작은 표본이에요. 그 안의 우연, 예를 들어 누가 한 점 차 승부를 유난히 많이 이겼는지, 누가 8월에 잠깐 부진했다가 9월에 회복했는지 같은 것이 그 시즌의 "최적 지수"를 좌우해요.
이게 데이터 분석에서 처음 만나는 개념 하나의 작은 사례예요. 오버피팅(overfitting) 이에요.
오버피팅 — 모델이 "외워버리는" 순간
오버피팅을 한 줄로 설명하면 이래요.
모델이 데이터의 진짜 패턴에 더해, 그 데이터의 우연까지 외워버린 상태.
각 시즌의 최적 k 를 구하면 그 시즌만큼은 MAE가 가장 작아져요. 2025 시즌에 k = 1.57을 쓰면 2025 시즌의 30팀에 대해서는 가장 잘 맞아요. 하지만 그 1.57로 2024 시즌을 예측하면, 2024 자신의 최적값 1.71보다 못해요. 1.57은 2025의 우연까지 외운 값이고, 그 우연은 다음 시즌에 반복되지 않아요.
데이터 분석에서는 이런 경우를 자주 만나요.
- 어떤 매출 데이터에서 "12개의 변수를 다 넣어 모델을 만들었더니 r² = 0.99가 나왔다" → 작년 매출을 외운 것에 가까울 수 있어요
- 머신러닝에서 학습 데이터 정확도는 99.9%인데 새 데이터에서 60% → 외운 거예요
- 이번처럼 시즌마다 최적 지수가 다르다 → 그 시즌만 잘 맞춘 결과일 가능성이 높아요
오버피팅을 피하는 가장 단순한 방법은 덜 튜닝하는 것이에요. 시즌별 최적이 1.57~1.76으로 흔들린다면, 한 시즌의 값에 고정하지 말고 여러 시즌에서 무난한 값을 쓰면 돼요. 1.83은 우리 시즌별 범위보다 조금 위에 있지만, 훨씬 긴 기간의 데이터에서 나온 값이라 한 시즌의 우연에 덜 흔들려요.
튜닝을 끝까지 밀어붙인 값보다, 무난한 값이 새 데이터에 더 잘 맞을 때가 많아요.
정리하면
- 피타고라스 공식의 k 를 1.50~2.50으로 스윕했어요.
- 우리 5시즌 데이터로는 k = 1.71이 최적이었어요.
- 빌 제임스의 2.00보다 0.42승, 업계 통설 1.83보다 0.10승 적게 빗나가요.
- 시즌마다 최적값이 1.57~1.76으로 흔들렸어요. 작은 표본의 한계예요.
- 그래서 긴 기간의 데이터에서 나온 1.83 같은 무난한 값이 한 시즌의 최적값보다 안전한 선택이에요. 오버피팅을 피하는 방법 중 하나예요.
이번 글에서 하이퍼파라미터와 오버피팅이라는 두 개념을 처음 다뤘어요.
다음 글
지난 글 끝에 이런 말을 남겼어요.
잔차가 +0.091 이 모두 운은 아니다. 일부는 실력이고 일부는 운이다. 그걸 어떻게 구별하지?
직접 답하기는 어렵지만, 다음 시즌으로 넘어가서 보면 단서가 나와요. 정말 운 좋은 시즌이었다면 다음 해엔 회귀할 거예요. 실력이었다면 다음 해에도 같은 방향으로 나타날 거예요.
2021년 +14.8승 운 좋았던 매리너스는 2022년에 어떻게 됐을까? 2023년 −11승 불운했던 파드리스는 2024년에 회복했을까?
다음 글의 주제는 평균 회귀(regression to the mean) 예요. 데이터로 확인하면서, 운과 실력을 어떻게 구별할 수 있는지 볼게요.
이 분석은 직접 만든 just-mlb의 Q3 페이지에서 확인할 수 있어요. MAE 곡선과 시즌별 최적 지수 표를 직접 만져 보고, 시즌 필터 칩으로 데이터를 한 시즌씩 떼 봐도 좋아요. 곡선이 시즌마다 어떻게 흔들리는지 한눈에 보여요.

